DeepSeek-V4.1-Flash-1017《看似寻常最奇崛》
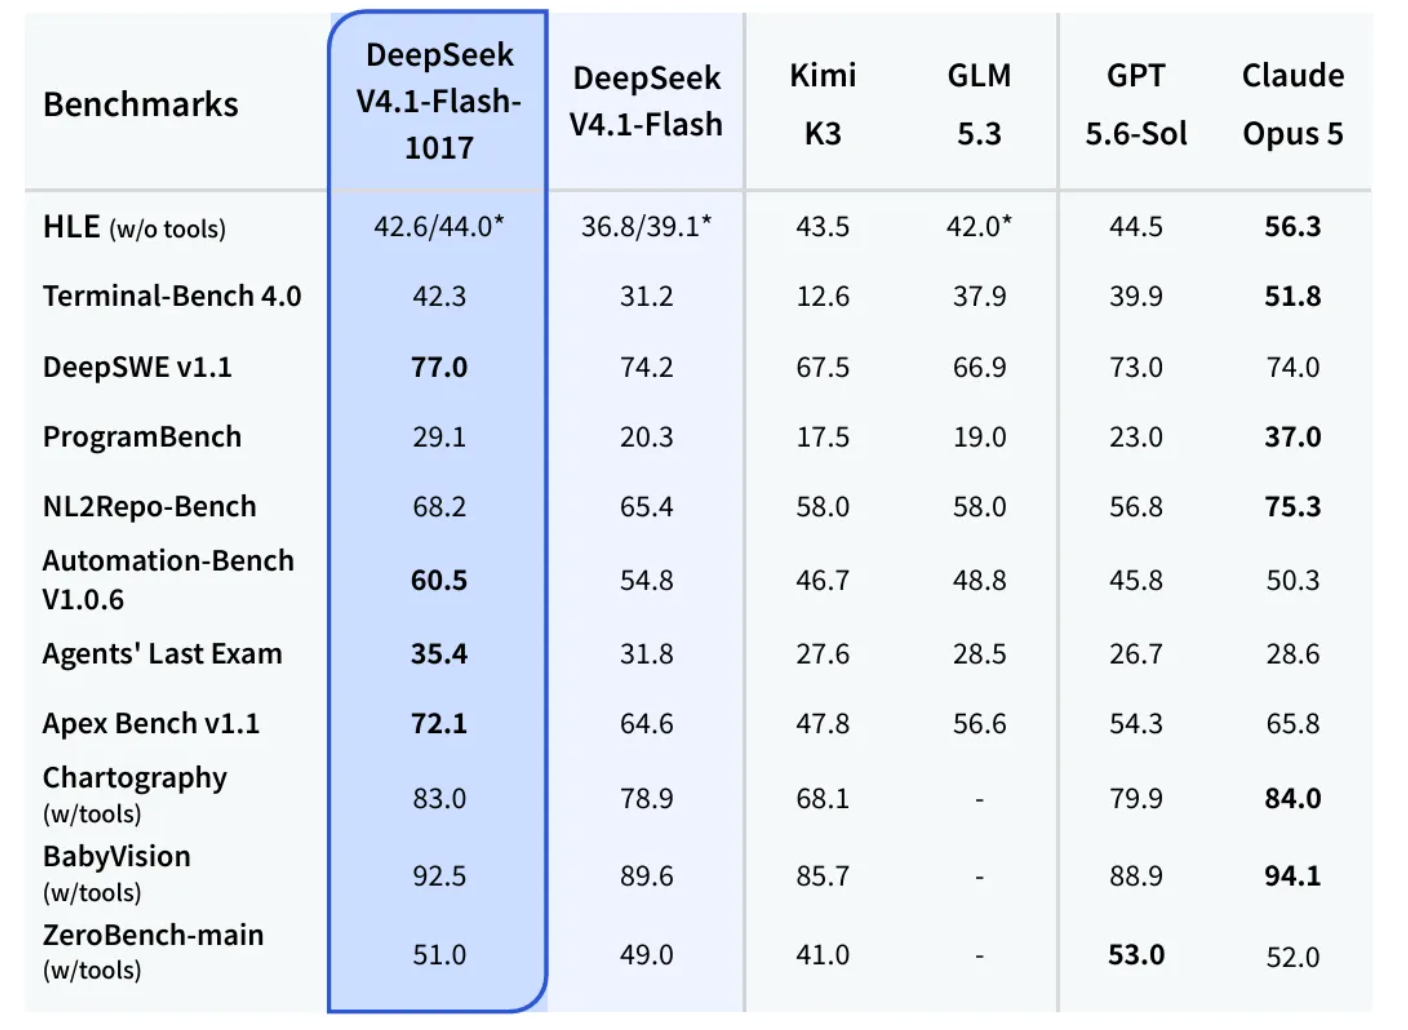
数据口径:本文的分数对比来自下附的同一张成绩表,排名来自 2026 年 10 月 17 日榜单快照。报表成绩不等于本文独立复测,同表列示也不代表各模型的测试配置已被独立核验一致;榜单其他来源的报数可能不同。
基本情况
三十七天。按榜单记录的版本日期,从 9 月 10 日的 DeepSeek-V4.1-Flash,到 10 月 17 日的 1017 版本,DeepSeek 完成了一次月余更新。这个节奏没有跨代换名那样醒目,但放在竞争对手不断更新的时间线上,也算紧凑:10 月综合榜的前三名,已经是 Claude Opus 5.5、Claude Sonnet 5.5 和 GPT-6 Astra。
1017 的变化集中在代码与 Agent 任务。Terminal-Bench 4.0 从 31.2 提升到 42.3,ProgramBench 从 20.3 到 29.1,Automation-Bench V1.0.6 从 54.8 到 60.5。相比继续堆一张更长的能力清单,这次成绩更像是在已有主场上补强。
结果也反映在月榜上:1017 的综合排名为全球第 14、国产第 1,对局得分率 88.7%;Code 排名为全球第 10、国产第 1,得分率 89.9%。作为对照,旧版在同一天的快照中分别排全球第 28 和第 15。它已进入代码方向的前列,但“国产双榜第一”还不能直接翻译成全面领先。各版本覆盖的基准不同,名次前移也不能理解成能力按同样比例增长。
这份材料没有给出可核验的参数规模、价格和时延,不能因为型号里有 Flash,就替它补出便宜、轻量或更快的定位。本文只讨论这次成绩表能回答的问题。
优势
代码能力:终端和程序任务,往前迈了一大步
最明显的改善在 Terminal-Bench 4.0:31.2 到 42.3,增加 11.1 分。同表的 GPT-5.6 Sol 为 39.9,GLM-5.3 为 37.9,1017 在这一项上都取得了领先。对需要在终端中执行任务的代码智能体来说,这比单纯展示几道编程题更值得留意。
ProgramBench 从 20.3 到 29.1,增加 8.8 分;DeepSWE v1.1 从 74.2 到 77.0,NL2Repo 从 65.4 到 68.2,各提高 2.8 分。几项基准的增幅不同,却都朝同一个方向移动。尤其 DeepSWE 的 77.0,高于同表 GPT-5.6 Sol 的 73.0 和 Claude Opus 5 的 74.0,是这张表六个模型中的最高值。
不过,77.0 的意义止于这张表及其测试口径。它足以支持“软件工程相关基准有进步”,还不能替代真实项目中的复测。ProgramBench 与 NL2Repo 的绝对分数也提醒我们:会在某类代码任务上领先,与各种开发任务都能接得住,仍有距离。
Agent 任务:三项同表领先,比一个总名次更具体
Automation-Bench V1.0.6 从 54.8 提升到 60.5,Agents’ Last Exam 从 31.8 到 35.4,Apex Bench v1.1 从 64.6 到 72.1,分别增加 5.7、3.6 和 7.5 分。
这三项也构成了 1017 对竞品最有说服力的一组同表对照。Claude Opus 5 的对应成绩为 50.3、28.6、65.8,1017 分别高出 10.2、6.8、6.3 分;Kimi K3 则为 46.7、27.6、47.8。三项中,1017 都是这张表的最高分。它的优势没有只落在某一道代码题上,Agent 类任务也出现了相互呼应的改善。
但分数不能替我们讲完行为故事。这里没有逐题轨迹,无法判断收益来自更好的规划、工具选择,还是其他环节;更不能据此写出“步数减少”“错误恢复更稳”之类的体验结论。能确认的是,三个不同基准的结果都出现了可记录的提升。对一次同系列更新,这已经是一份扎实的答卷。
带工具的视觉任务:差距缩小了,但还没有反超
视觉部分没有代码指标那样醒目的跨越,却也值得单独看。Chartography(w/tools)从 78.9 到 83.0,BabyVision(w/tools)从 89.6 到 92.5,ZeroBench-main(w/tools)从 49.0 到 51.0,分别提高 4.1、2.9、2.0 分。
同表 Claude Opus 5 的对应成绩为 84.0、94.1、52.0。1017 目前分别落后 1.0、1.6、1.0 分,比旧版与这三个分数之间的距离都更近。Chartography 的 83.0 也超过了 GPT-5.6 Sol 的 79.9,BabyVision 的 92.5 高于后者的 88.9。同表 GPT-5.6 Sol 的 ZeroBench 为 53.0,仍高于 1017 的 51.0;视觉任务的进展并不整齐,不能用两项领先概括全部结果。
这组数据支持的判断是:在这些允许使用工具的视觉任务上,新版本更接近同表的领先模型。它们不能直接证明纯视觉感知能力同步提升了多少,也不能与不带工具的同名测试混算。把设置写清楚,这几分的进步才有意义。
不足
极限推理仍有距离,HLE 的星号也不能略过
HLE(w/o tools)从旧版的 36.8/39.1* 提升到 42.6/44.0*。只比较斜杠前的数值,增幅为 5.8 分,但仍低于同表 Kimi K3 的 43.5、GPT-5.6 Sol 的 44.5,更落后于 Claude Opus 5 的 56.3,差距为 13.7 分。
截图没有附上星号说明,本文保留复合写法,不把 44.0* 擅自解释成某种推理档位或普通设置成绩。这一项能看见进步,也能看见尚未跨过去的上沿;至于差距的成因,现有材料不足以下判断。
代码强项之外,仍有不能绕开的失分
DeepSWE 的同表领先没有覆盖全部代码基准。ProgramBench 为 29.1,仍落后于 Claude Opus 5 的 37.0;NL2Repo 为 68.2,对方为 75.3,差距为 7.1 分。Terminal-Bench 4.0 虽提高了 11.1 分,42.3 与 Opus 5 的 51.8 之间仍差 9.5 分。
因此,Code 国产第一可以作为当前榜单结果引用,却不能成为省略任务差异的理由。同一张成绩表里,1017 既有领先项,也有明确落后项,用户遇到哪一种任务,依然会影响体验。
双榜第一的证据边界,是目前只报了 11 项
1017 目前收录 11 项成绩,其中进入默认综合排名计算的有 7 项,进入 Code 的有 5 项。General 集合中只有 2 项有效指标,未达到 5 项门槛,因此没有 General 名次。这是数据覆盖不足,不等于已测出通用能力较弱。
88.7% 和 89.9% 是已有共同基准上的对局得分率,不是统一试卷的正确率。项目中也没有这一版本的 ClawProBench 实测,不能拿旧版 Flash 的结果代替。排名值得记录,但有关更广任务覆盖和实际使用表现的结论,还需要更多证据。
酥悠沫评
我更愿意记住这次更新里的 31.2 到 42.3,而不是先记住“国产第一”。一个名次会随着参评模型和已知分数变化,终端任务上多出的 11.1 分、ProgramBench 多出的 8.8 分,却把这次更新的方向说得很清楚。
DeepSeek 这次交出的成绩,有几分老实:DeepSWE 从 74.2 磨到 77.0,Automation-Bench 从 54.8 推到 60.5;该领先的地方有领先,该落后的地方也还在。把它写成一次全面反超,会辜负那些真正有分量的进步。
王安石写:“看似寻常最奇崛,成如容易却艰辛。”用在这里,不必替团队想象一段没有资料支持的苦战。只看成绩,一些提升不过两三分,但在已经不低的起点上继续向前,本就值得认真对待。
双榜国产第一是这一天的记录。接下来,若能用更广的测试、可复核的实际任务,把这 11 项成绩之外的地方也填起来,这个第一才会更有分量。期待下一次更新时,我们可以少解释一点证据的边界,多谈一点模型真正走到了哪里。
数据与榜单:
- 本次成绩表
- 综合榜单
- 2026 年 10 月榜单
- ClawProBench 榜单(本文未引用 1017 版本成绩,项目中暂无对应实测。)