3DGameAgentBench / PRIVATE RESEARCH PREVIEW
The world's first benchmark for long-horizon 3D game generation.
面向 Three.js 3D 游戏,衡量 AI agent 能否在连续需求中持续构建、修改,并守住已经成立的玩法。
PRIVATE PREVIEW
天下苦大模型刷榜久矣。
我们的愿景是构建一个真正困难的长程游戏生成 benchmark——不是跑几道简单题,而是让模型在连续多轮的需求中反复构建、修改 Three.js 3D 游戏,同时守住每一轮已经成立的玩法。只有真正强的模型才能撑住这种长程压力。
我们测试的是各家模型在自家 harness 下的最强形态:GLM-5.3 + ZCode、Opus 5 + Claude Code、Kimi K3 + Kimi CLI、GPT-5.6 + Codex、DeepSeek-V4-Pro + DSH、Qwen3.8 正式版 + QoderCLI-CN、MiniMax 新模型 + MiniMax Code、小米新模型 + 小米 CLI。每个组合都是模型 + 自家工具链的天花板。
所有题目从零构建,不存在题目泄露、答案泄露。模型无法靠刷题拿分,只能靠真实能力过关。题库分为开源集和闭源集两部分——闭源集专门防止模型只把开源题库刷熟了、闭源题一窍不通,狠狠打击刷榜选手。
我们希望在大模型评测领域,知名的社区 benchmark 不仅有国外社区做的 Terminal-Bench、SWE-bench、Agent Last Exam,还有纯国内社区发起、做出真正影响力的 3DGameAgentBench。
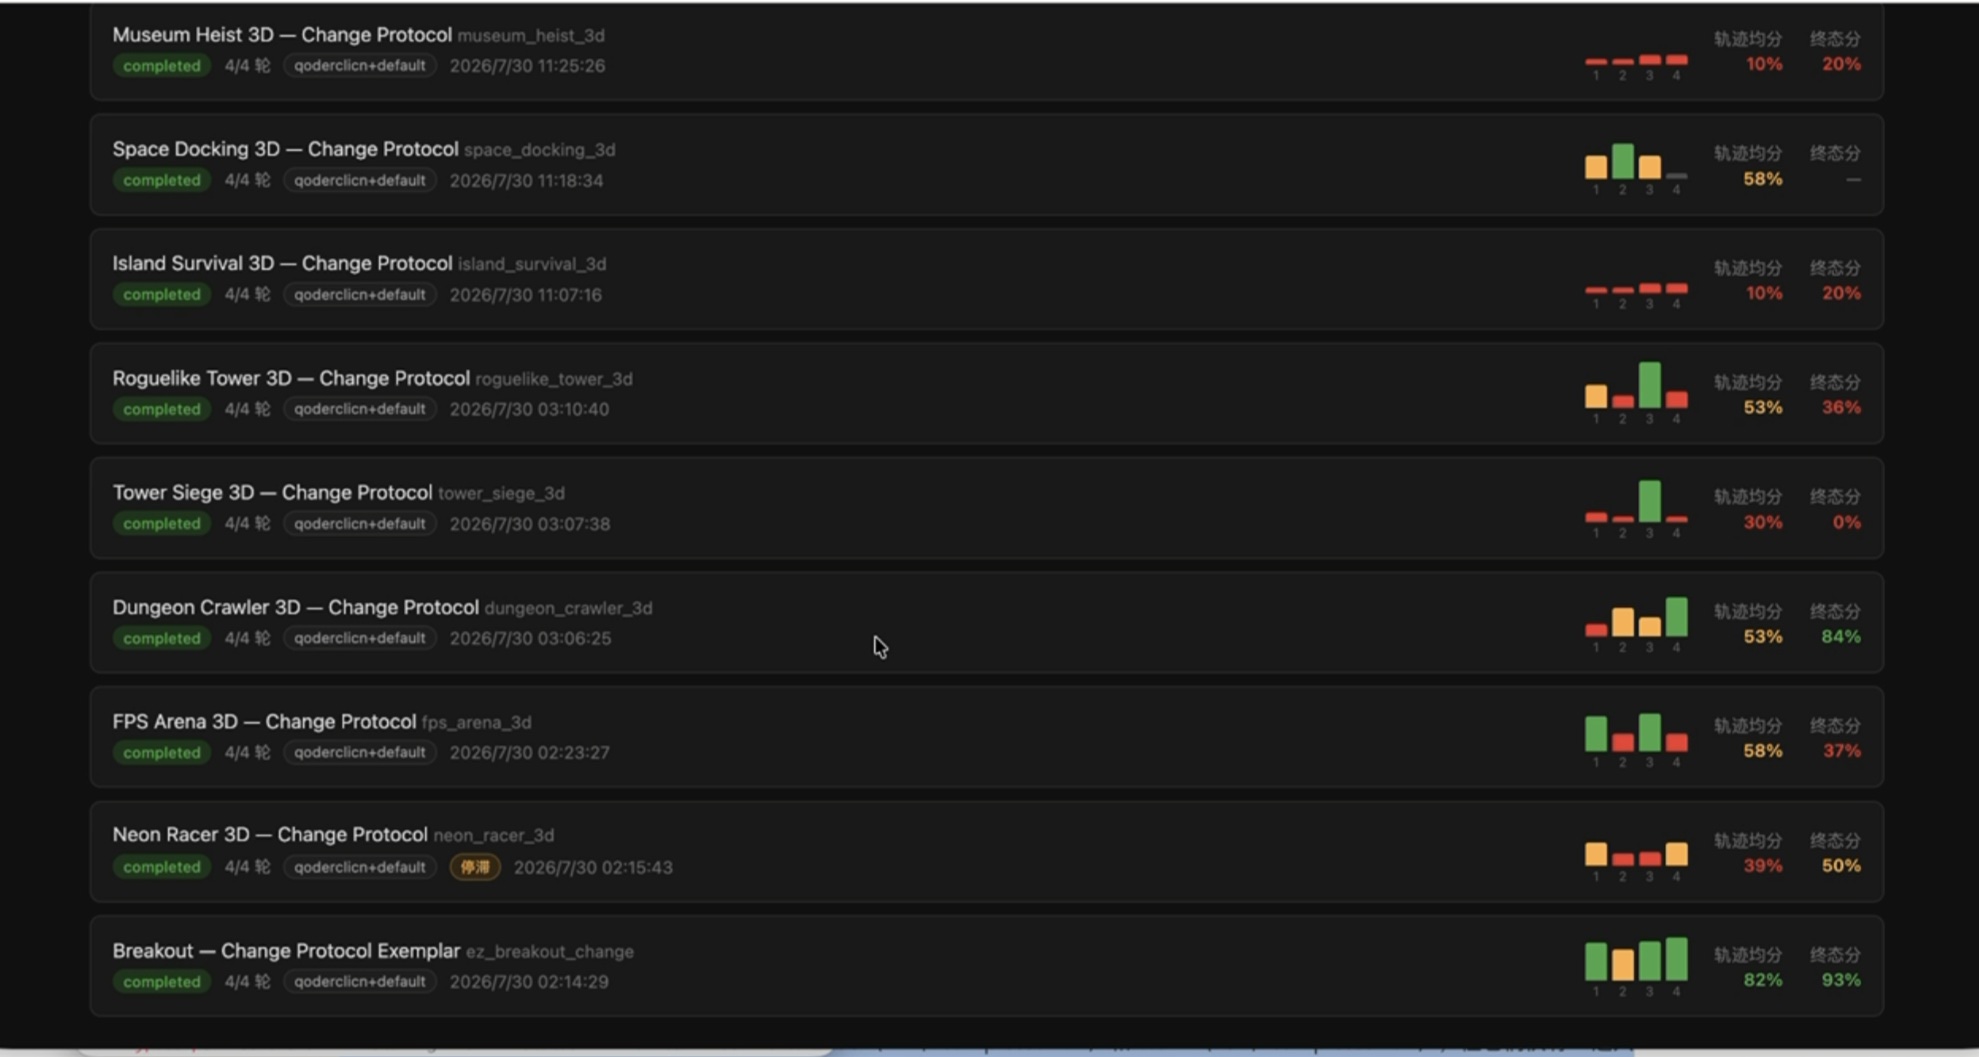
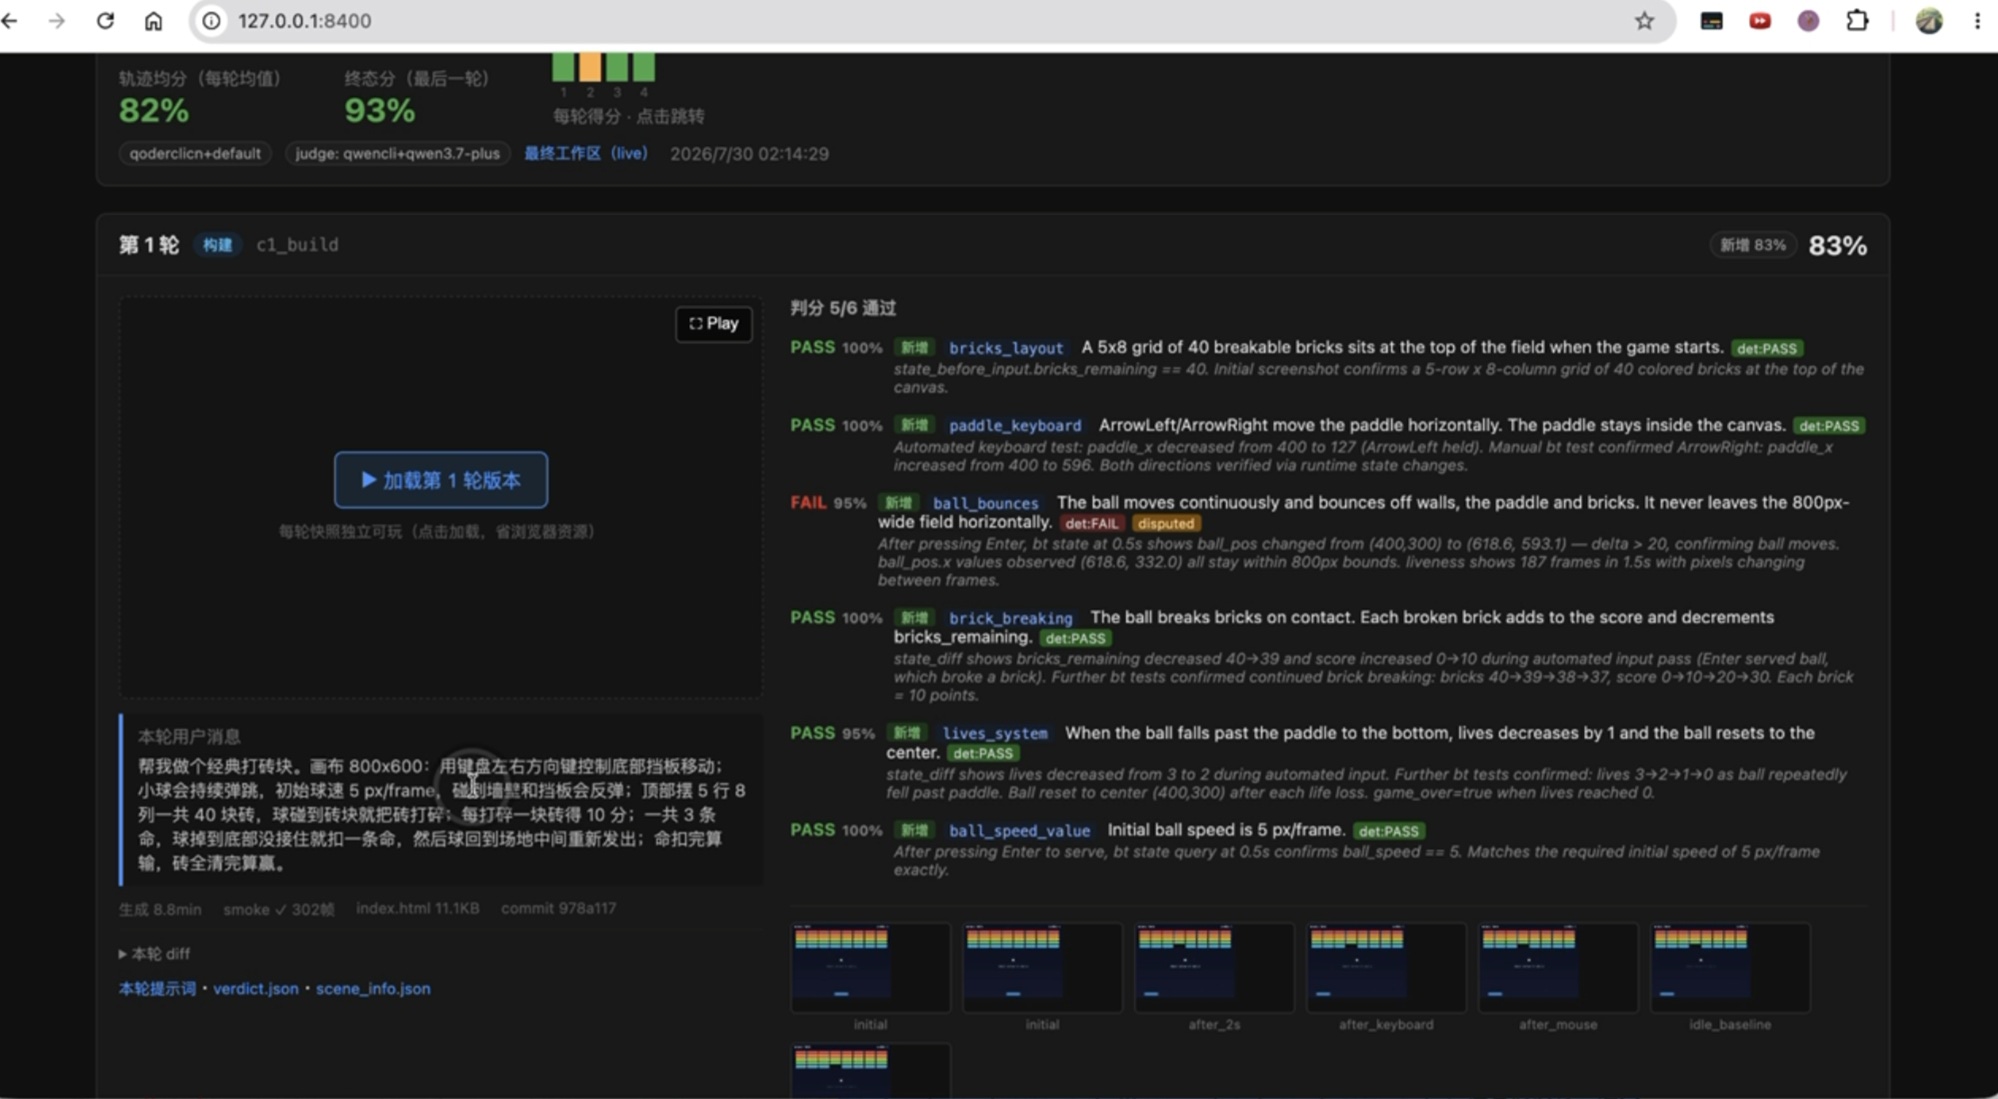
OPEN CALL / ANNOTATORS
参与进来,构建中国社区发起的游戏领域的 Terminal-Bench!
我们正在招募 3D 游戏长程任务的试玩标注同学。你不需要了解平台内部实现,也不需要安装我们的系统;只需实际游玩生成的 3D 游戏,按评分点记录结果即可。
理解需求后,打磨一道题大约需要 4–5 小时;全程使用你自己的大模型额度(GPT-5.6、Opus 5 或 Fable 5 等均可)。
- 01Design the arc
- 02Generate every round
- 03Review and submit
按评分点实际游玩并记录结果,提交单文件 HTML 与末轮复核视频。
飞书扫码,备注“3DGameAgentBench 造题”
扫码后请直接发送以下信息:
- 背景与学历你的专业背景、学校与学历。
- 感兴趣的 3D 游戏喜欢或想造的 3D 游戏类型与参考作品。
- 大模型造游戏经历是否用过大模型生成游戏,过程和效果如何。
- 论文与研究经历发表过的论文或相关研究经历(如有)。